你刷到的“猜你喜欢”,背后是协同过滤在抄作业
你有没有过这种瞬间:打开音乐App,每日推荐第一首正好戳中你。或者刚在购物App看了一眼猫粮,首页立刻冒出一排猫砂盆。你心里嘀咕:它怎么知道?
别急。很多时候,它不是“懂你”,它只是找到了一群和你口味相似的人。然后,把那些人的选择搬到你面前。这个办法,就叫协同过滤。
人话版:协同过滤就是“抄邻居的作业”
想象一个宿舍。你不爱说话,但你的室友A和你听歌口味很像。A最近疯狂循环一首冷门歌。你还没听过,可推荐系统会想:这俩人品味重合这么多,A喜欢的,你大概率也不讨厌。
于是,那首歌就出现在你首页了。就这么朴素。
协同过滤分两路。一路是基于用户的协同过滤:找你相似的人,看他们喜欢啥,再推给你。另一路是基于物品的协同过滤:你点了A物品,系统发现A和B经常被同一批人喜欢,于是把B塞给你。前者像“跟你像的人都在看”,后者像“买了这个的人也在买那个”。
注意,它不需要知道歌是什么风格、猫粮是什么口味。它只看行为:谁点了什么、谁打了分、谁买了什么。行为变成数字,数字放进一张巨大的表里。表里全是空白和稀疏的勾勾。然后算相似度。完事。
它不是读心术,更像一场大型相亲
有人觉得推荐系统背后有个AI在分析自己的灵魂。说实话,想多了。
协同过滤的数学部分很枯燥。余弦相似度、皮尔逊相关系数、矩阵分解……听着头大对吧?但核心动作就一个:找相近,做预测。你给某样东西打了高分,系统就找和你打分习惯像的人。他们给另一样东西打了高分,而你没看过,那东西就可能被推过来。
问题也在这儿。新用户刚注册,什么行为都没有。系统两眼一抹黑。这叫冷启动。新歌、新商品也一样,没人互动,就很难被协同过滤捞起来。于是平台可能先塞给你一些热门内容,或者让你选几个标签。不是它笨,是它真的没数据可抄。
还有稀疏性。一个平台如果有几百万件商品,一个用户这辈子可能就买几十件。那张用户-物品表,空白多得像深夜的教室。相似度算起来就没那么稳。偶尔推得离谱,也正常。你看到推荐“马桶刷+巧克力”这种鬼组合,别笑,背后可能只是几个奇怪用户的共同行为被算法抓住了。
为什么你越刷越像自己?
协同过滤有个副作用:它会自我强化。
你点了猫视频。系统推更多猫。你继续点。系统更确信你爱猫。于是首页全是猫。你偶尔想看看狗,但狗视频没机会冒出来。这叫反馈循环,也常被说成信息茧房、过滤气泡。它不是协同过滤独有,但协同过滤很容易参与其中。
短视频平台尤其明显。推荐流不是一次算完,而是边刷边学。你的每一次停留、划走、点赞、复播,都是新数据。系统不需要你填问卷,它看你的手指。
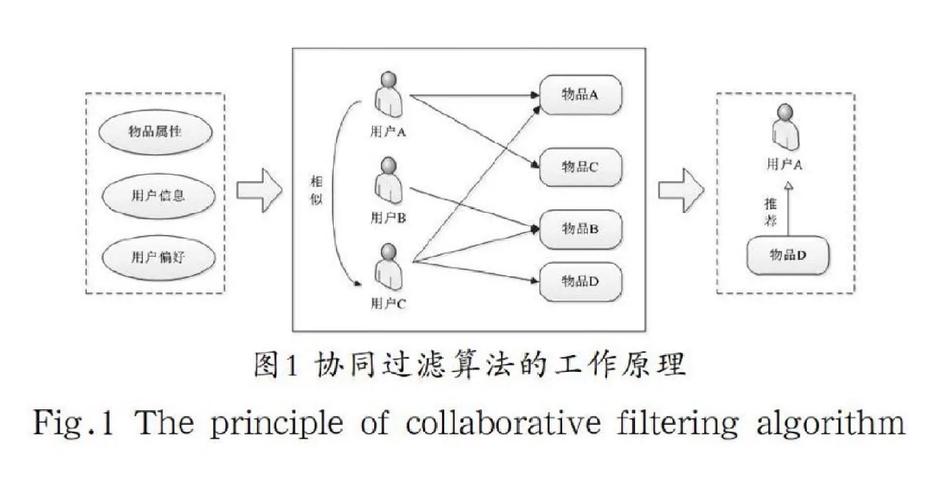
有时候准到吓人。有时候又烦人。你只是想随便看看,它却拼命把你往老路上拽。协同过滤很少单独工作,平台还会混上内容特征、热度、时间、地域等等。但“找相似的人/物”这个底层思路,一直在。
日常里,它藏在哪些角落
豆瓣的“喜欢这部电影的人也喜欢”,是经典协同过滤味道。网易云音乐的每日推荐、私人FM,也绕不开它。淘宝京东的“猜你喜欢”“买了又买”,常常是基于物品的协同过滤。B站首页、抖音推荐流,更是把用户行为、物品关系和实时反馈搅在一起。
你发现没?这些场景有个共同点:选择太多,人懒得挑。推荐系统不是让你没得选,而是先替你缩小范围。至于缩得对不对,另说。
我自己的体验是,基于物品的推荐有时候更稳。因为物品之间的关系变化慢。喜欢《星际穿越》的人,大概率不排斥《降临》。但基于用户的推荐容易飘。你这个月迷烘焙,下个月去钓鱼,系统还拿旧邻居的爱好往你嘴里塞,就很尴尬。
做推荐的人,每天都在和什么较劲

不是调个参数就完事。真做起来,一堆麻烦。
数据太稀。用户行为少,算不准。冷启动。新东西没曝光,永远没数据,永远出不来。可解释性差。你问它为什么推这个,它只能说“相似”。多样性难平衡。全推准的,用户会腻;推太偏,用户跑掉。还有实时性。刚才点了一下,下一秒推荐流就得变,不然显得迟钝。
所以平台常做A/B测试,分组看点击、停留、转化。听起来理性,但也会带来偏向。点击高的内容被推更多,推更多又获得更多点击。热闹的更热闹,冷门的更冷门。协同过滤本身不制造偏见,它只是放大已有行为。
下次看到“猜你喜欢”,可以这样想
它不一定在监视你。它可能只是在无数匿名行为里,找到几个和你轨迹相似的人,然后小声说:喂,这个你要不要试试?
有点神奇,也有点粗糙。像朋友推荐,也像群体跟风。准的时候让人惊喜,不准的时候让人翻白眼。
所以,别把推荐当命令。划走、点不感兴趣、偶尔搜点新东西,都是在给系统重新画方向。你不动,它就默认你一直爱看猫。可谁知道呢,也许你今天想看的是修驴蹄。
算法在猜你,你也在训练它。这场拉锯,挺有意思的。