大模型为什么会一本正经地胡说八道?聊聊我踩过的坑
上个月我妈让我用手机上那个“能聊天的东西”查一下,西瓜在冰箱里放三天还能不能吃。
她问了三次。三个答案。
我妈把手机往桌上一扣:“这东西是不是有点毛病。”
我笑了半天。后来想想,她这一问,正好戳在大模型最要命的那个点上。
它不是在“想”,它是在接龙
很多人第一次用大模型,会有种很奇怪的感觉——它好像真的听懂了。你说一句,它接一句,语气还跟你似的。
但你把它拆开看,里面没有一个人在思考。一个都没有。
它干的事,说白了就一件:根据前面所有的字,猜下一个字最可能是什么。
猜完一个,把猜出来的那个塞回去,再猜下一个。一直猜到它觉得该停了为止。
这跟手机输入法是一回事。我打“南京”,下面自动蹦出“南站”“大学”“天气”。它不知道我要去哪,它只是见过太多人这么打过。
大模型就是把这件事做到了极致——见过的句子多到吓人,参数多到吓人,所以猜得准到吓人。
但底层逻辑没变。它还是个接龙的。
所以它才会一本正经地胡说八道
这就要说到那个最出名的问题:幻觉。
你问它某本书的作者是谁,它不知道。但它不会说“我不知道”。它会给你编一个。
而且编得特别顺,特别像真的,甚至给你配上年份和出版社。
为什么?因为它的任务从来不是“说真话”,而是“说得像话”。
我常跟人打这个比方:它像一个特别会讲话、但从来不查资料的远房亲戚。饭桌上什么都能聊,聊得全场点头,你回头一查,一半是错的。
更像的是——它压根没有“我不会”这个状态。
人答不上来会脸红,会卡壳。它不会。它的词库里没有“卡壳”这个出口,只有“下一个词”。
所以它永远有话说。这一点,比它说错话更值得警惕。
那为什么同一个问题,它每次答得都不一样
我妈问西瓜问了三次,三个答案,这就是原因之一。
大模型输出的时候,并不是每次都挑概率最高的那个词。它是在一堆候选里按概率抽。
有个参数专门管这个,叫“温度”。温度低,它就死板,每次都挑最稳的那个;温度高,它就放飞,什么词都敢往外蹦。
你可以理解成点菜。温度低的人,是那种永远点老三样的;温度高的人,是闭着眼睛指着菜单乱点的。
做翻译、写代码,一般把温度调低——要的是稳。陪你聊天,就调高一点——要的是不那么像机器。
所以同一个问题问两遍答案不一样,不是它坏了,是它本来就这么设计的。
还有件事:它其实记性特别差
这点很多人误会。你以为它记得你上周跟它聊过什么。没有。
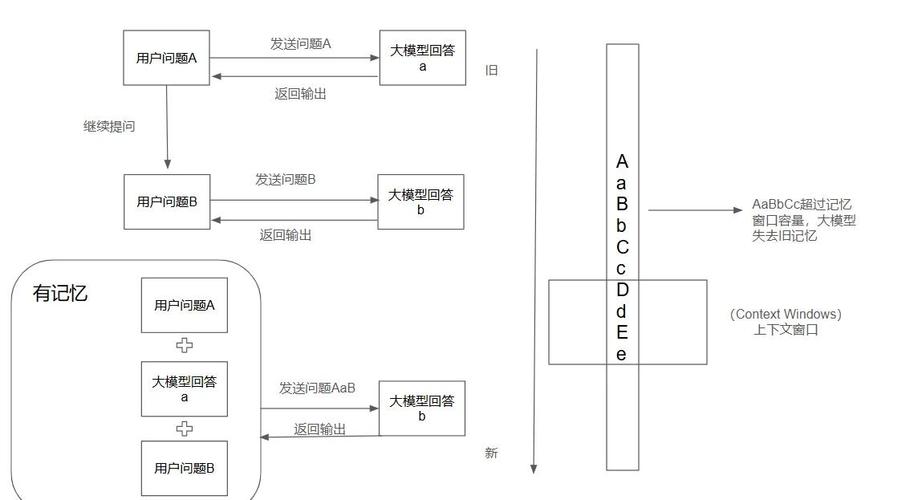
它每次回你话之前,会把你们这一整段对话从头读一遍,然后接着往下说。读得完,它就显得记性好;读不完,前面说的它就真忘了。
这个“一次能读多长”的限制,叫上下文窗口。
就好比开会。它手里只有最近这几页会议记录,再往前翻,没了。
所以你要是跟它聊得特别久,它突然开始犯糊涂、前言不搭后语——不是你哪里说错了,是它把开头那部分给丢出去了。
解决办法也土:重要的东西,重新说一遍。
那普通人到底该怎么用它

说几个我自己踩坑踩出来的习惯,不讲大道理。
别拿它当搜索引擎。问“某某事件是哪一年”,它可能给你编一个。这种事去搜,别问。它的强项不是查事实,是整理、是改写、是换个说法。
先给材料,再让它干活。你想让它帮你写个东西,别空手问。把资料、把要求、把你想要的那个调调,一股脑丢给它。它手里有东西,接龙才接得准。
它答得不对,就直接说“不对,重来”。不用客气。它不会觉得受伤,也不会记仇——它连你上一句都可能已经忘了。你越具体地告诉它错在哪,它下一轮就越接近你要的。
别指望它替你判断。它能给你三个方案,选哪个是你的事。它能写出一堆看起来很有道理的话,哪句能信,也是你的事。
说到底,这东西有点像一个嘴特别甜、反应特别快、但从来没出过门的年轻人。你让他帮你跑腿、帮你整理、帮你想几个说法,都挺好使。
但你要是把方向盘的判断权也交出去,那就不是他骗你,是你自己松的手。
我妈现在用得可溜了。她原话是:“当个嘴甜的小伙子使唤使唤就行,别当大夫。”
我觉得她总结得比我好。