语音识别:它到底在听什么?我对着手机吼了三年才明白
昨晚想发条消息,懒得打字,按住语音键说“我在南木绿荫写稿子”。松手一看,屏幕上赫然显示:“我在南无绿阴写稿子”。南无?我当场石化。这已经不是第一次了。上次说“去新街口”,它给我转成“去新接口”。接口?我又不是去修电脑。
语音识别这玩意儿,天天用,但真要问它怎么工作,大部分人可能跟我一样——只知道对着手机说话,然后文字就出来了。像变魔术。但魔术背后,往往是一堆让人头秃的数学和代码。
手机语音输入法识别错误显示“南无绿阴”截图 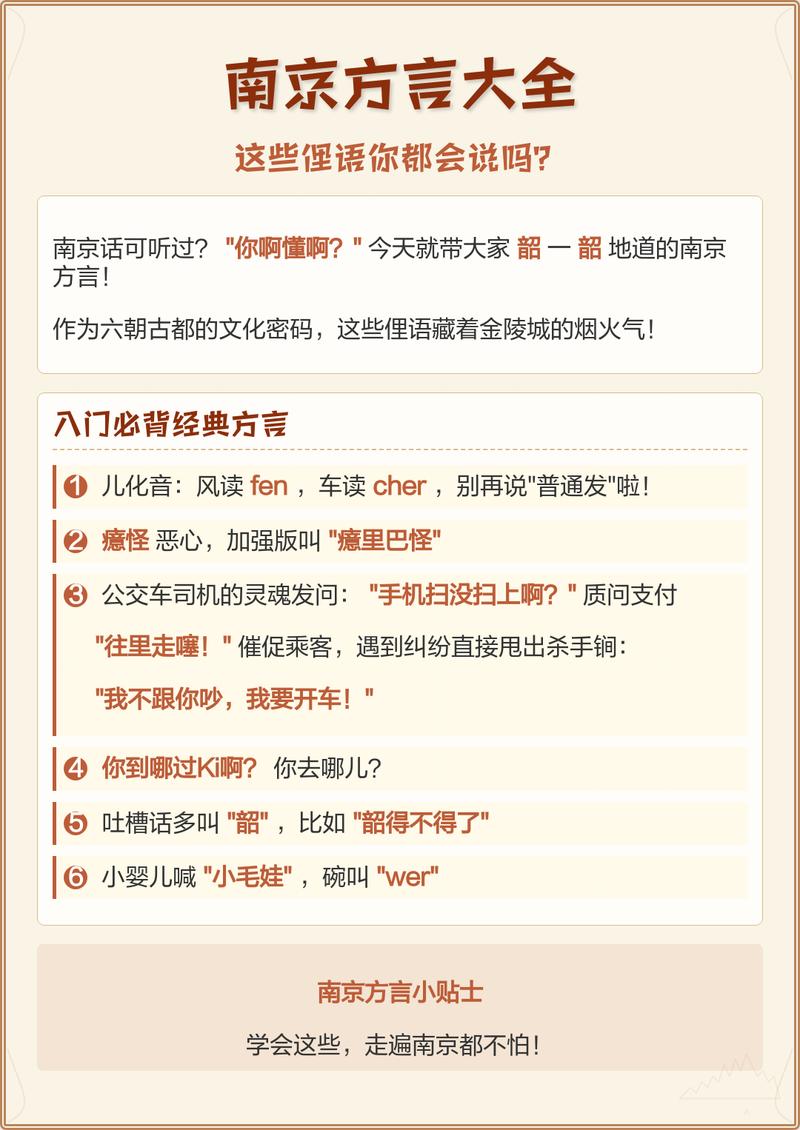
方言语音识别测试界面显示南京话识别错误 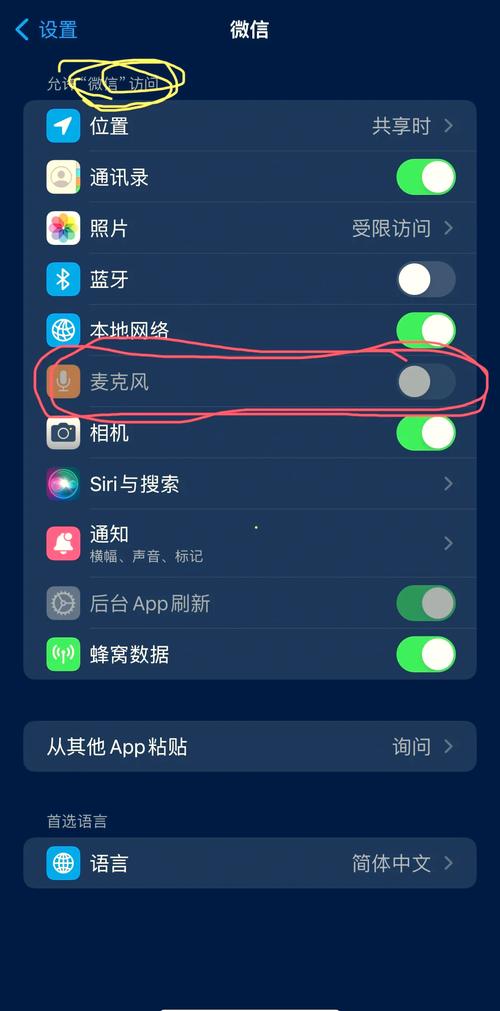
手机设置中麦克风权限管理界面截图 
未来它能不能听懂人话里的“意思”
它不是在“听”,是在“猜”
你对着手机说“今天天气不错”,它其实没听懂“天气”是什么意思。它只是从一堆可能的文字里,挑出最像你刚才发音的那串。说白了,就是个超级猜谜游戏。 声音是连续的波,麦克风把声波变成电信号,再采样成数字。然后切成一小段一小段,比如每25毫秒一帧。每一帧提取特征,像梅尔频率倒谱系数(MFCC),这名字听着就劝退。但你可以理解为,把声音的“音色”变成一组数字指纹。 然后声学模型上场。以前用高斯混合模型-隐马尔可夫模型(GMM-HMM),现在基本都是深度学习,比如循环神经网络、Transformer。声学模型负责回答:这几帧声音,对应哪个音素?比如“n”还是“l”?南京人可能深有体会,n和l不分,语音识别也跟着懵。 不过光有声学模型不够。它还得猜词。这时候语言模型来了。语言模型知道“今天天气”后面跟“不错”的概率,比跟“不措”高。所以哪怕声学模型听成了“不措”,语言模型也会把它掰回“不错”。 最后解码器综合两者,找出最可能的文字序列。这就好比你在KTV听朋友唱走调的歌,虽然每个音都不准,但你还是能猜出他唱的是《后来》。为什么方言和口音总让它翻车
说实话,语音识别在标准普通话上已经挺厉害了。但你试试用南京话跟它说“啊要辣油啊”,它可能给你整出“啊要酱油啊”。方言的发音、语调、词汇跟普通话差太远,模型训练时见得少,自然就懵。 还有口音。我有个朋友是福建人,他说“飞机”,语音识别出来“灰机”。他说“吃饭”,出来“呲饭”。他气得改用打字。但你能怪语音识别吗?它从小只听过标准播音腔,突然来个胡建口音,相当于让一个只学过文言文的人去听rap,能猜对才怪。 不过现在有些厂商开始针对方言做优化。比如粤语、四川话的识别率就比前几年好多了。但南京话?嗯……我还在等。你手机里的语音识别,到底偷听了多少
很多人担心语音识别会一直偷听。比如你刚说想买火锅,打开购物App就给你推火锅底料。这事儿吧,你得分开看。 有些是唤醒词机制。比如智能音箱,它本地有个小模型,只监听“小爱同学”或“Hey Siri”这样的唤醒词。听到唤醒词之前,它确实在听,但只是把声音转成一堆特征,判断是不是唤醒词,并没有上传。听到唤醒词之后,才把后面的语音传到云端识别。 但手机上的语音输入,一般是你按住按钮才启动。不按的时候,麦克风权限虽然开着,但系统通常不会持续录音。当然,不排除有些App耍流氓。所以定期检查麦克风权限,没必要的就关掉。 不过话说回来,语音识别确实需要大量数据训练。你每次用语音输入,如果同意改进计划,你的语音片段可能就被拿去训练模型了。所以有些隐私敏感的人,宁愿打字。未来它能不能听懂人话里的“意思”